Datele de antrenare reprezintă fundamentul pe care sunt construite sistemele moderne de inteligență artificială, însă calitatea și proveniența acestora pot influența direct rezultatele obținute. De la asistenți virtuali și motoare de căutare inteligente până la modele capabile să genereze imagini, texte sau cod, toate aceste tehnologii depind de cantități uriașe de informații folosite pentru învățare. În spatele performanței impresionante a AI-ului există însă o provocare complexă: cum sunt colectate, selectate și utilizate aceste date.
Ce sunt datele de antrenare pentru inteligența artificială
Datele de antrenare sunt informațiile folosite pentru a învăța un model de inteligență artificială să recunoască tipare și să ia decizii. Acestea pot include texte, imagini, înregistrări audio, videoclipuri, cod sursă sau alte tipuri de informații digitale.
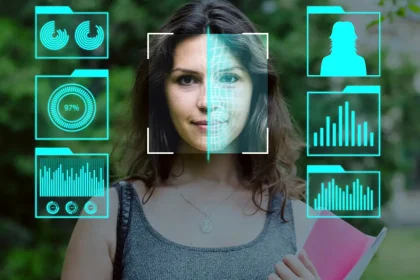
Un model AI nu înțelege lumea în același mod în care o face un om. El analizează volume foarte mari de exemple și identifică relații statistice între elementele disponibile. De exemplu, un sistem antrenat să recunoască obiecte în imagini are nevoie de milioane de fotografii etichetate corespunzător pentru a învăța diferențele dintre diverse categorii.
În cazul modelelor de limbaj, procesul este similar. Acestea sunt antrenate folosind cantități mari de texte pentru a învăța structura limbii, relațiile dintre cuvinte și modul în care sunt formulate răspunsurile.
De ce calitatea datelor este mai importantă decât cantitatea
Unul dintre cele mai importante principii din dezvoltarea inteligenței artificiale este că un model bun are nevoie de date bune. O cantitate mare de informații nu garantează automat rezultate corecte.
Dacă datele de antrenare conțin erori, informații incorecte sau exemple dezechilibrate, modelul poate învăța aceste probleme și le poate reproduce ulterior. Acest fenomen este cunoscut sub numele de „garbage in, garbage out”, ceea ce înseamnă că rezultatele sunt limitate de calitatea informațiilor introduse.
De exemplu, un sistem AI folosit pentru analizarea imaginilor medicale trebuie antrenat cu date precise și reprezentative. Dacă setul de date nu include suficiente variații sau conține clasificări greșite, performanța sistemului poate fi afectată.
Problema prejudecăților din datele AI
Una dintre cele mai discutate probleme legate de datele de antrenare este apariția prejudecăților algoritmice. Inteligența artificială poate reproduce sau amplifica anumite modele incorecte existente în datele pe care le analizează.
Dacă un set de date reflectă anumite dezechilibre sociale, culturale sau istorice, modelul poate ajunge să ofere rezultate influențate de aceste dezechilibre. Acest aspect este important în domenii precum recrutarea profesională, evaluarea riscurilor financiare, securitatea sau sistemele de recomandare.
Eliminarea completă a prejudecăților este dificilă deoarece datele reale provin din lumea reală, unde există deja numeroase diferențe și inegalități. De aceea, dezvoltatorii trebuie să folosească metode de verificare, curățare și evaluare permanentă a seturilor de date.
Drepturile de autor și proveniența informațiilor
O altă problemă majoră este legată de sursa datelor utilizate pentru antrenarea modelelor AI. Multe sisteme au nevoie de cantități uriașe de informații disponibile online, ceea ce ridică întrebări despre drepturile de autor și utilizarea conținutului creat de oameni.
Textele, imaginile, operele artistice sau materialele audio pot fi protejate legal, iar folosirea lor pentru antrenarea modelelor de inteligență artificială a generat numeroase dezbateri în industria tehnologică.
Pe măsură ce AI-ul devine tot mai prezent în domenii creative și profesionale, transparența privind sursele de date și modul de utilizare a acestora devine un subiect esențial.
Cum sunt pregătite datele înainte de antrenare
Înainte ca informațiile să fie folosite pentru antrenarea unui model AI, acestea trec printr-un proces complex de pregătire. Datele brute pot conține duplicate, erori, informații irelevante sau elemente care pot afecta rezultatele.
Procesul include curățarea datelor, eliminarea conținutului nepotrivit, clasificarea informațiilor și uneori etichetarea manuală realizată de oameni. În multe cazuri, această etapă necesită foarte mult timp și resurse.
De exemplu, pentru ca un model să învețe să identifice anumite obiecte într-o imagine, cineva trebuie să indice ce apare în fiecare fotografie. Această activitate de etichetare este una dintre componentele importante ale dezvoltării sistemelor AI.
Confidențialitatea datelor și riscurile de securitate
Folosirea unor cantități mari de informații ridică și probleme legate de protecția datelor personale. Dacă seturile de antrenare includ informații sensibile, există riscul ca acestea să fie utilizate fără acord sau să fie expuse accidental.
De aceea, dezvoltatorii trebuie să implementeze metode de anonimizare și protecție a datelor. În anumite domenii, precum sănătatea sau sectorul financiar, regulile privind utilizarea informațiilor sunt mult mai stricte.
Inteligența artificială are nevoie de date pentru a evolua, dar modul în care aceste date sunt gestionate influențează încrederea utilizatorilor în tehnologie.
Viitorul datelor de antrenare pentru AI
Pe măsură ce modelele de inteligență artificială devin mai complexe, atenția se mută tot mai mult de la simpla colectare a informațiilor către calitatea, diversitatea și responsabilitatea utilizării acestora. Viitoarele sisteme AI vor depinde nu doar de algoritmi mai performanți, ci și de seturi de date mai bine construite.
Datele de antrenare sunt componenta invizibilă care determină cât de utilă, corectă și sigură poate fi inteligența artificială. Înțelegerea acestui aspect ajută utilizatorii și companiile să privească tehnologia mai realist, dincolo de rezultatele spectaculoase afișate la suprafață. Pentru proiecte bazate pe AI, este importantă alegerea unor soluții dezvoltate responsabil, iar consultarea specialiștilor poate contribui la utilizarea eficientă și sigură a acestor tehnologii.